Biaya Cetak
Ringkasan
Print-Cost saya bangun dari pengalaman pribadi waktu masih kuliah, saat saya menjalankan usaha cetak kecil-kecilan. Waktu itu menentukan harga dokumen masih manual, banyak mengandalkan feeling, pengalaman, dan hitungan cepat di kepala sambil antrean pelanggan mengular.
Usahanya sekarang sudah tidak jalan lagi karena saya sudah kerja full-time, tapi masalahnya masih sangat nyata. Project ini cara saya menengok lagi masalah lama itu dan menyelesaikannya dengan benar pakai Machine Learning dan Data Science.
Tiga pekerjaan sekaligus
Waktu masih mengoperasikan toko cetaknya, saya sering harus:
- Melayani pelanggan yang mau cetak dokumen
- Menghitung harga cetak halaman per halaman
- Melayani penjualan alat tulis (ATK) di saat yang sama
Tantangannya, harga cetak tidak sesederhana hitam-putih. Ada halaman yang full color, ada yang isinya hampir hitam semua, ada juga yang cuma punya sedikit elemen berwarna seperti logo. Saat jam sibuk, menghitung harga dengan akurat sementara antrean harus tetap jalan itu bikin stres dan rawan salah.
Dari sisi pelanggan, pengalamannya juga tidak ideal:
- Mereka tidak punya estimasi harga yang jelas sebelum datang ke toko
- Biaya akhirnya terasa tidak bisa ditebak
- Kadang ini bikin pelanggan tidak puas, padahal operatornya tidak berniat buruk sama sekali
Rata-rata butuh sekitar 1 detik per halaman, cuma buat menentukan kategori harganya. Kedengarannya kecil, tapi jadi bottleneck serius untuk dokumen yang ratusan halaman.
Dokumen itu data
Dari pengalaman itu, muncul satu pertanyaan sederhana:
“Kenapa biaya cetak masih harus dihitung manual, padahal dokumen itu pada dasarnya data?”
Pertanyaan itu jadi dasar project ini. Tujuannya membangun sistem yang bekerja otomatis:
- Menganalisis tiap halaman dokumen
- Mengukur pemakaian tinta
- Menentukan kategori harga yang adil dan konsisten
Yang penting bukan cuma kecepatannya. Hasilnya juga lebih konsisten dan transparan, baik buat operator maupun pelanggan.
Cara mesin meniru feeling saya
Mengubah halaman jadi angka tinta
Tiap halaman PDF diubah jadi gambar, lalu dikonversi dari RGB ke ruang warna CMYK. Dari situ bisa dihitung persentase pemakaian tinta Cyan, Magenta, Yellow, dan Black per halaman.
Melabeli 884 halaman dalam satu sore
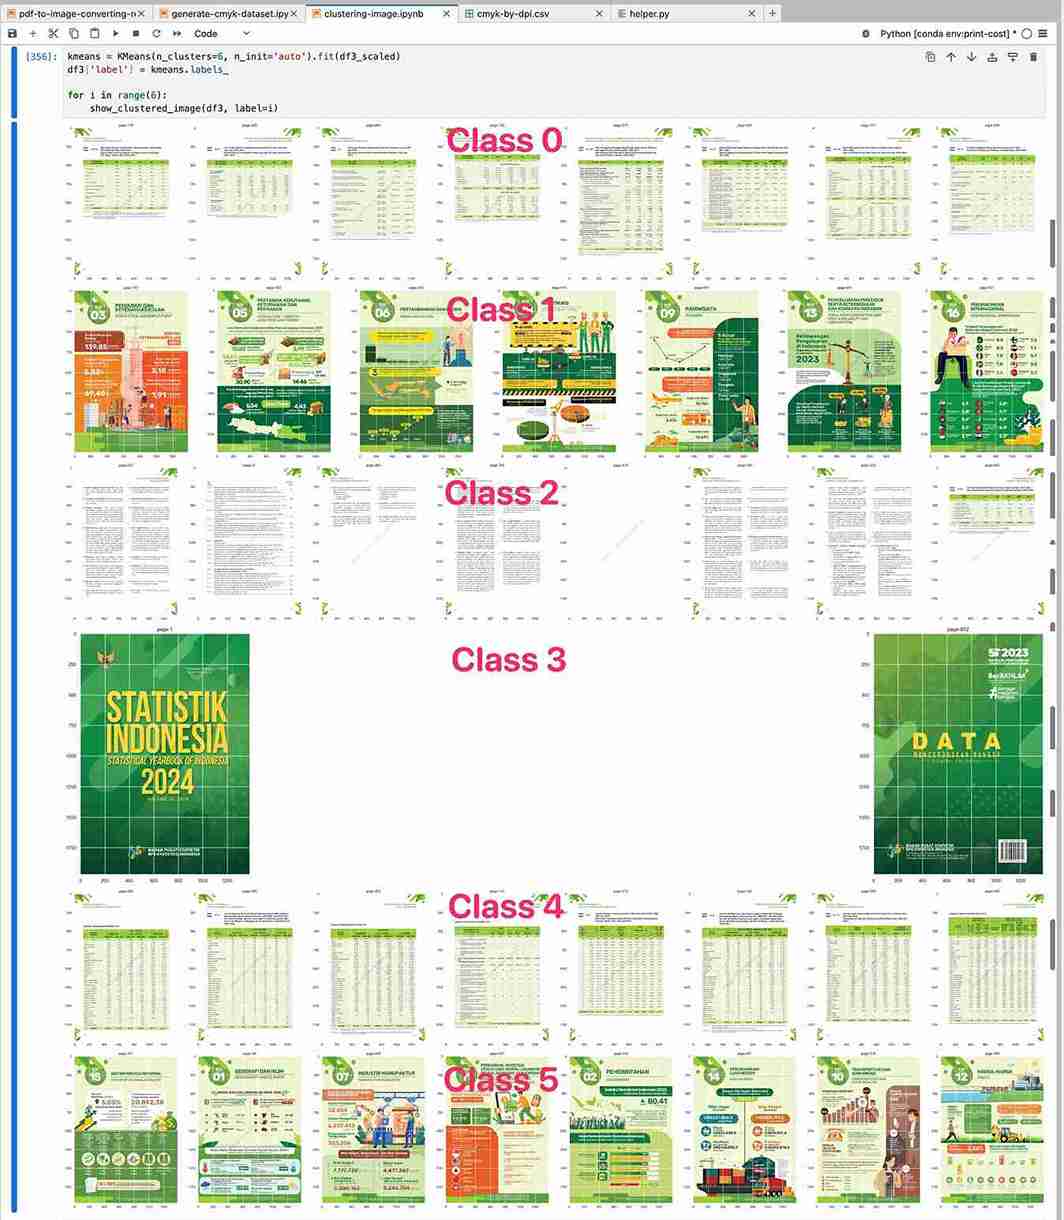
Karena dataset awalnya belum punya label harga, saya pakai K-Means clustering untuk mengelompokkan 884 halaman ke 6 cluster berdasarkan kemiripan warnanya.
Cluster itu lalu saya petakan secara manual ke 5 kategori harga (Rp500–Rp2000), dan cara ini bikin proses labeling jadi 147× lebih cepat dibanding melabeli halaman satu per satu.
Kenapa 7 DPI yang menang
Setelah datanya punya label, saya melatih classifier XGBoost. Setelah coba-coba beberapa setting kualitas, 7 DPI jadi pilihan paling efisien: feature extraction-nya cepat dan dampaknya ke performa model minimal.
Arsitektur
graph TB
    subgraph Labeling offline - sekali saja
        P884[884 halaman tanpa label] --> KM[K-Means 6 cluster]
        KM --> MAP[petakan manual ke 5 kelas harga]
    end
    subgraph Pricing online - per upload
        PDF[Upload PDF pengguna] --> API[Endpoint kalkulasi FastAPI]
        API --> IMG[image processor PDF ke tinta CMYK]
        IMG --> XGB[Klasifier XGBoost via model manager]
        XGB --> CALC[cost calculator]
        CALC --> RES[ringkasan + pie chart + tooltip]
    end
    MAP -. label .-> XGB
Yang keluar
Walaupun project ini berangkat dari usaha kecil yang sekarang sudah tidak jalan, hasilnya cukup signifikan:
- 🚀 109× lebih cepat dibanding hitung manual (109 halaman per detik)
- ⏱️ Dokumen 884 halaman bisa dihitung harganya dalam 8.13 detik
- 🎯 F1 Score 99%, dengan error handling yang condong melindungi pelanggan:
- Mending harga sedikit kurang daripada menagih pelanggan kemahalan.
Di luar performa model, project ini juga memperbaiki pengalaman pelanggan:
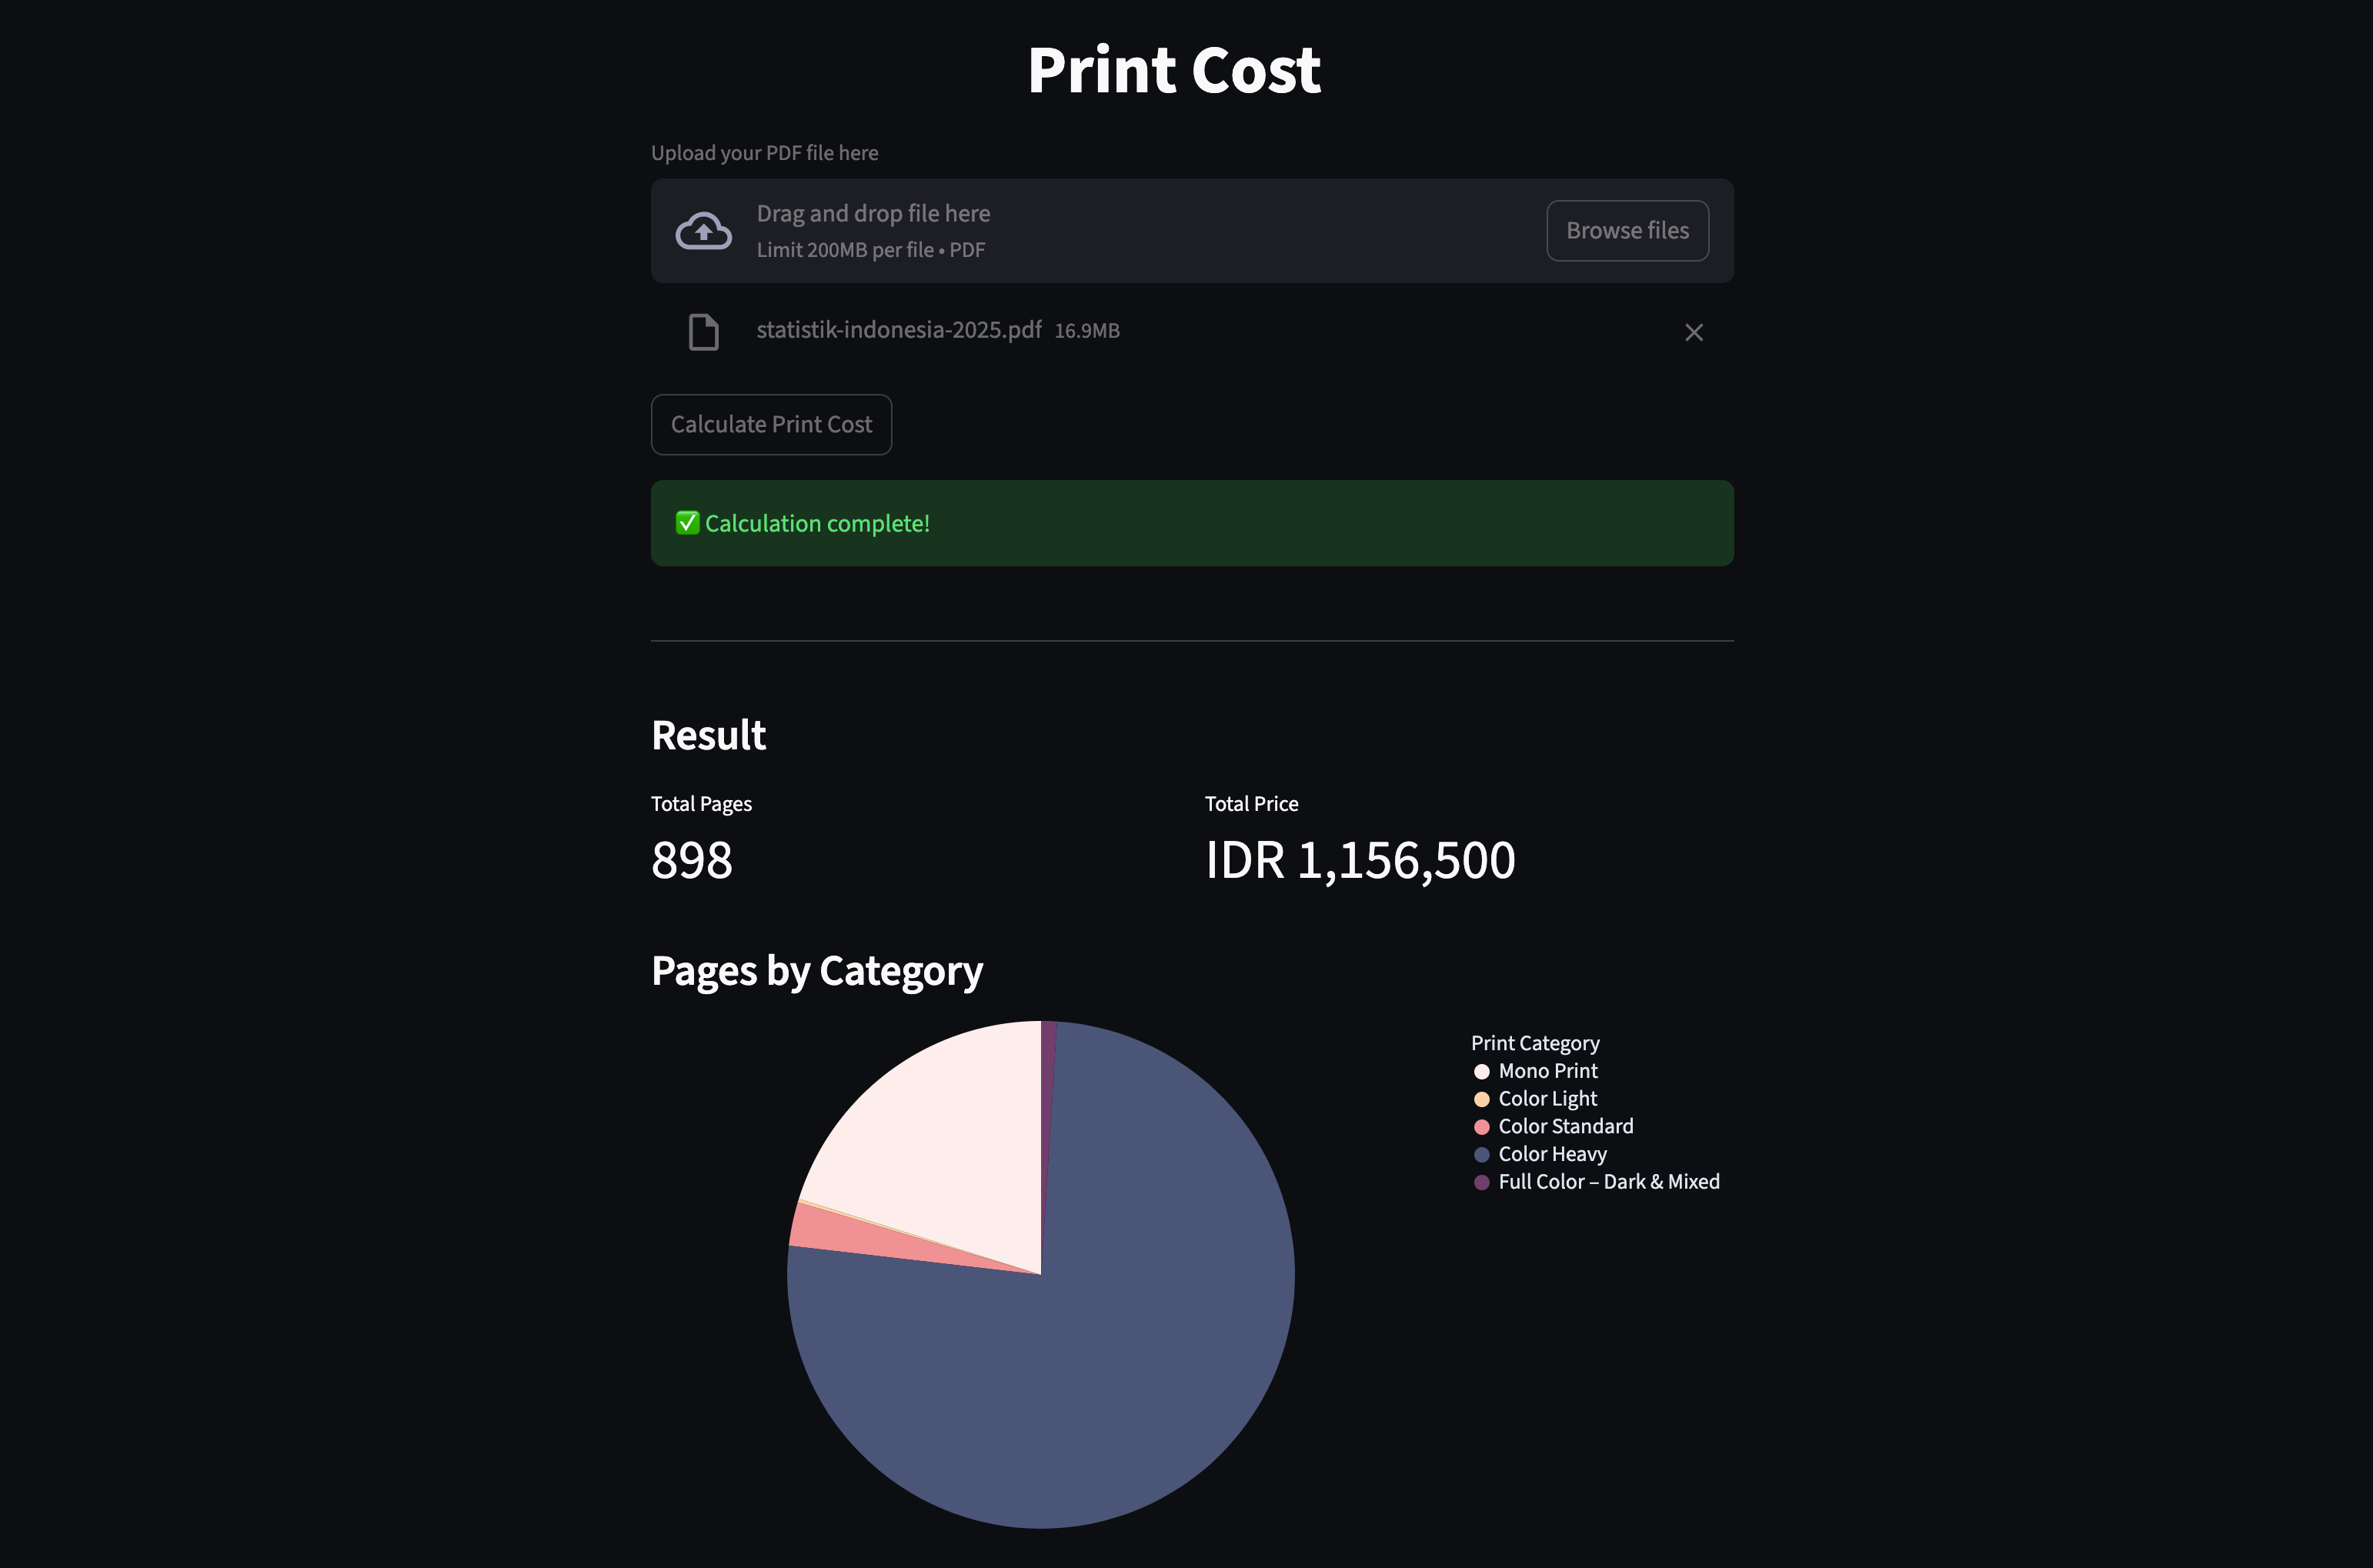
- 📄 Ringkasan visual sederhana yang menampilkan jumlah halaman dan harga akhir
- 🥧 Pie chart berisi distribusi kategori harga berdasarkan intensitas warna tiap halaman
- 🖱️ Visualisasi interaktif dengan tooltip, jadi pelanggan bisa lihat:
- Berapa halaman yang masuk ke tiap kategori harga
- Kenapa dokumen tertentu lebih mahal dari yang lain
Visual ini bikin harga jadi lebih transparan dan gampang dimengerti, sekaligus menumbuhkan kepercayaan antara tukang cetak dan pelanggannya.
Dari sini kelihatan, masalah operasional sesederhana ini pun bisa diselesaikan dengan data, dan hasilnya menguntungkan dua sisi: pemilik usaha dan pelanggan.
Coba sendiri
Kalau penasaran cara kerjanya di praktik, kamu bisa lihat implementasi dan live demo-nya:
-
🔗 GitHub Repository: https://github.com/rasyidev/print-cost
-
🚀 Live Demo: https://rasyidev-print-cost.hf.space
Repository-nya berisi source code lengkap dan pipeline model, sedangkan di live demo kamu bisa lihat langsung bagaimana biaya cetak dihitung dan divisualisasikan secara real-time.


Yang belum saya percaya mentah-mentah
Print-Cost bukan cuma project Machine Learning buat saya. Ini masalah nyata yang saya alami sendiri, lalu saya kerjakan lagi dengan tools dan pengalaman yang lebih baik.
Walau usaha cetaknya sudah tidak aktif, masalah yang sama masih ada di banyak toko cetak kecil sampai sekarang. Lewat project ini saya ingin menunjukkan bagaimana Data Science bisa benar-benar memperbaiki operasional usaha kecil di praktik nyata.
Satu hal yang sampai sekarang masih saya timbang: pemetaan cluster ke kategori harga tetap manual, dan menurut saya memang lebih pas manual, karena harga itu soal kebijakan pemilik usaha, bukan cuma soal model.