Toko Cetak di Kepala Saya: Menentukan Harga dengan Perasaan
- Habib Abdurrasyid
- 04 Apr, 2022
- · 4 mnt baca
Daftar isi
Waktu kuliah saya punya usaha cetak kecil dari kamar kos. Teman-teman mengirim tugas, saya cetak, mereka bayar. Saya menghitung harga per lembar secara manual, membolak-balik setiap halaman, lalu pakai intuisi untuk menentukan harga. Pekerjaan ini memerlukan fokus yang tinggi dan tidak bisa diganggu, setidaknya untuk saya yang tidak bisa multi-tasking. Sekali saja ada yang memanggil saya, hitungan harga cetak ter-reset dan harus menghitung ulang. Huft, pekerjaan yang melelahkan bagi saya.
File PDF sepuluh halaman, sebagian besar teks, Rp500. Oke lanjut. Halaman kedua ada gambar dan ada teks, jelas lebih mahal, Rp1.000. Lalu halaman ketiga sebagian besar gambar dan ada sedikit teks berwarna, tapi berapa? Antrean menumpuk di grup chat dan tidak ada waktu buat menghitung. Jadi saya tebak, cepat, dan berharap tetap untung untuk diputar kembali menjadi modal membeli kertas dan tinta.
Tebakan itu punya pola
Bertahun-tahun kemudian saya menoleh ke belakang dan sadar tebakan itu punya aturan. Saya memindai tiap halaman lalu memasukkannya ke dalam kategori: teks polos, grafik ringan, warna pekat, foto sehalaman. Lima kategori, kira-kira. Harga ditentukan oleh kategorinya, bukan dari perhitungan.
Pengamatan itu menjadi Print-Cost. Kalau mata saya bisa memilah halaman ke lima kategori, classifier juga bisa.
Mengajari mesin melihat tinta
Pipeline-nya cukup sederhana untuk dijelaskan sambil ngopi. Tiap halaman PDF menjadi gambar. Gambar dikonversi dari RGB ke CMYK, color space yang memang dipakai printer. Dari sana saya ukur berapa banyak tinta cyan, magenta, yellow, dan black yang dibutuhkan tiap halaman.
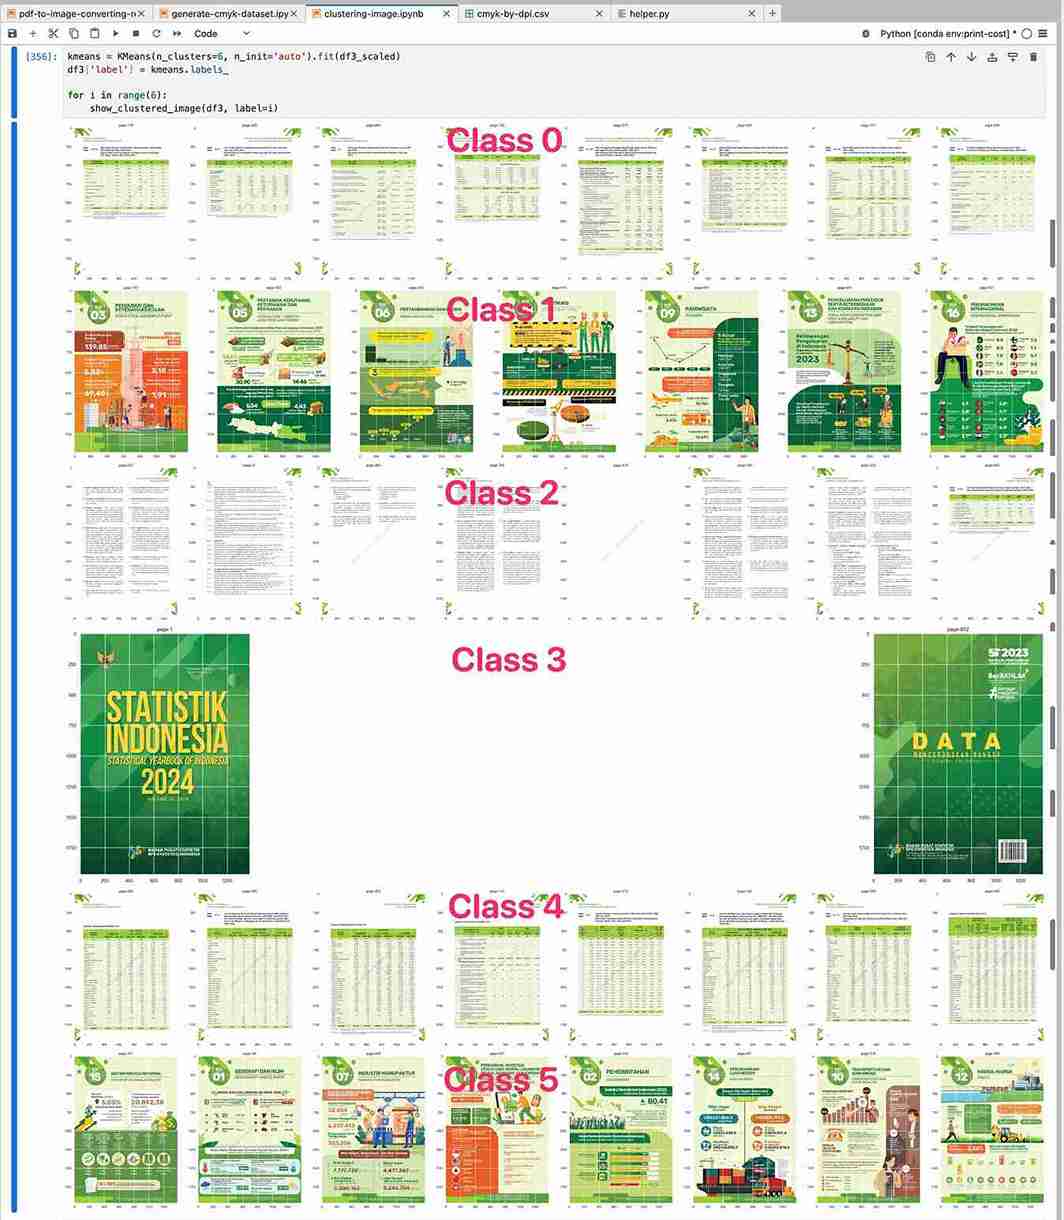
Bagian tersulit adalah label. Datanya 884 halaman dari buku Statistik Indonesia (data publik BPS), campuran halaman teks, tabel, infografik, sampai sampul full color, tapi semuanya tanpa label. Jadi saya melakukan clustering dengan K-Means menjadi 6 grup berdasarkan kemiripan visual, lalu memetakannya secara manual ke lima kategori harga yang sama dengan yang saya pakai waktu kuliah. Melabeli semuanya dengan tangan butuh berhari-hari. Dengan cara ini, saya cuma perlu melabeli 6 cluster, bukan 884 halaman satu per satu: sekitar 147 kali lebih sedikit pekerjaan.
Setiap halaman yang sudah diberi label saya export menjadi gambar dengan variasi resolusi yang berbeda-beda: 1, 5, 6, 7, 20, 50, 100, 150 dalam skala DPI.
Otak-atik Model, Parameter, Data Input, dan Feature Engineering
Data sudah lengkap dengan feature C, M, Y, K dan DPI serta harga sebagai targetnya. Karena mahalnya harga cetak ditentukan oleh banyaknya warna, saya membuat fitur baru: cmy (gabungan cyan, magenta, dan yellow) dan cmyk (total semua channel), di samping k (tinta hitam). Harapannya, fitur ini membantu model mengenali pola data dan menaikkan akurasi.
Lalu saya membandingkan tiga model: XGBoost, Decision Tree, dan SVM. Kebetulan XGBoost yang paling bagus. Setelah beberapa kali percobaan pengaturan kualitas gambar, 7 DPI menang. 7 DPI secara visual memang sangat buram kalau dilihat mata manusia, tapi bagi model machine learning (dari hasil percobaan), ternyata 7 DPI sudah cukup untuk memprediksi harga cetak. Resolusi lebih tinggi memang memberi akurasi sedikit lebih baik, tapi waktu export halaman PDF menjadi gambar juga makin besar. 7 DPI jadi sweet spot-nya: performa nyaris tidak turun dan ekstraksi jauh lebih cepat. Dokumen 884 halaman selesai dihitung sekitar 8 detik, 109 kali lebih cepat daripada menghitung manual yang rentan salah dan tentu saja melelahkan.
Skornya 99% F1, dengan satu bias yang disengaja. Saat salah, ia cenderung memasang harga sedikit lebih rendah daripada menagih terlalu mahal. Toko yang menagih terlalu mahal kehilangan pelanggan, jadi saya memilih menaruh risiko error di sisi saya sebagai pemilik usaha percetakan.
Yang tidak bisa ia lakukan
Model tahu lima kategori dan tidak tahu apa-apa lagi. Ia tidak bisa menjawab pertanyaan customer, tidak bisa melihat stok, tidak bisa memberikan informasi detail produk.
Print-Cost menjawab tepat satu pertanyaan: tiap halaman masuk kategori mana, dan berapa harganya. Hari ketika seseorang bertanya apakah jilid spiral cocok untuk skripsi, ia tidak bisa menjawab. Keterbatasan itulah alasan agen Dokuprint ada.